
Von Prompt und RAG bis Agent und Harness: Die wichtigsten KI-Begriffe verständlich erklärt und für die Praxis eingeordnet.
Künstliche Intelligenz unterstützt beim Recherchieren, Schreiben, Analysieren und Automatisieren. Mit den Anwendungsmöglichkeiten wächst auch die Zahl der Fachbegriffe. Manche beschreiben die technische Grundlage, andere den Umgang mit Informationen oder die Handlungsmöglichkeiten eines Systems.
Diese Unterschiede sind im Arbeitsalltag relevant: Ein Sprachmodell erzeugt Antworten, eine Suchfunktion erschliesst Quellen, ein Agent kann mehrstufige Aufgaben bearbeiten. Wer die Begriffe einordnen kann, formuliert klarere Anforderungen und beurteilt Möglichkeiten und Grenzen einer Anwendung fundierter.
Dieses Glossar bietet dafür Orientierung. Es erklärt zentrale Begriffe, zeigt ihre Zusammenhänge und verbindet technische Grundlagen mit praktischen Beispielen. Die thematische Gliederung ermöglicht sowohl einen Einstieg ins Thema als auch das gezielte Nachschlagen – ohne technisches Vorwissen.
Die Grundlagen: Was hinter einer KI-Anwendung steckt
Oberbegriff für Computersysteme, die beispielsweise Sprache verarbeiten, Muster erkennen, Vorhersagen treffen oder Aufgaben planen. KI umfasst wesentlich mehr als Chatbots.
Verfahren, bei denen Systeme aus Daten Muster lernen. Statt jede Regel einzeln zu programmieren, trainiert man ein Modell anhand von Daten und Lernzielen.
Eine Form des maschinellen Lernens mit neuronalen Netzen aus vielen Schichten. Diese lernen komplexe Merkmale aus Daten. Datenaufbereitung und Qualitätskontrolle bleiben wichtig.
KI, die Inhalte wie Texte, Bilder, Musik oder Programmcode erzeugt. Grundlage sind gelernte Muster. Die Ergebnisse sind weder automatisch richtig noch garantiert neuartig.
Ein auf grossen Datenmengen trainiertes Modell zur Verarbeitung und Erzeugung von Sprache. LLM steht für «Large Language Model». Bei der Textgenerierung berechnet es passende nächste Textbausteine anhand des Kontexts und gelernter Zusammenhänge.
Die Software, über die wir mit KI arbeiten. Sie verbindet Modelle mit Funktionen wie Suche, Dateiverarbeitung oder Speicher. Anwendung und Modell sind deshalb nicht dasselbe.
Steht für «Generative Pre-trained Transformer»: ein generatives, vortrainiertes Modell auf Basis der Transformer-Architektur. Bekannt wurde der Begriff durch OpenAIs Modellreihe.
Die Fähigkeit, mehrere Informationsarten zu verarbeiten, etwa Text, Bilder und Audio. Welche Formate ein Modell verstehen oder erzeugen kann, hängt vom jeweiligen Modell ab.
Die Zusammenarbeit: Aufgaben und Kontext verständlich machen
Die Eingabe oder Arbeitsanweisung an die KI. Ein hilfreicher Prompt beschreibt die Aufgabe, liefert relevante Informationen und benennt das gewünschte Ergebnis.
Das systematische Formulieren, Testen und Verbessern von Prompts. Ein klares Ziel, die Zielgruppe, passende Beispiele und das gewünschte Ausgabeformat helfen dabei.
Übergeordnete Anweisungen der Anwendung, etwa zur Rolle, zum Verhalten oder zu Grenzen der KI. Sie sind für Nutzende häufig nicht sichtbar.
Beim Prompting bedeutet das: kein Beispiel, ein Beispiel oder mehrere Beispiele für die gewünschte Bearbeitung mitgeben. Gemeint sind Beispiele im Prompt, nicht im ursprünglichen Training. Vertiefung: Beispiele im Prompt
Das gezielte Zusammenstellen und Verwalten der Informationen, die ein Modell für eine Aufgabe erhält: Anweisungen, Gesprächsverlauf, Dokumente und Werkzeugergebnisse. Prompt Engineering ist ein Teil davon. Vertiefung: Kontext gestalten
Ein Verarbeitungsbaustein des Modells. Bei Text kann das ein Wort, ein Wortteil oder ein Satzzeichen sein. Tokenmengen beeinflussen Kapazität, Kosten und Verarbeitungszeit.
Die maximale Informationsmenge, die ein Modell in einem Verarbeitungsschritt berücksichtigen kann. Ein grosses Kontextfenster garantiert nicht, dass jedes Detail gleich zuverlässig genutzt wird.
Ein langer Gesprächs- oder Arbeitsverlauf wird auf wesentliche Informationen reduziert, damit die Aufgabe innerhalb des Kontextfensters weitergeführt werden kann. Dabei können Details verloren gehen.
Eine Funktion der Anwendung, die ausgewählte Informationen über Gespräche hinweg speichert und später wieder bereitstellt. Das ist nicht automatisch ein erneutes Training des Modells.
Eine Einstellung, die die Zufälligkeit bei der Auswahl der nächsten Token beeinflusst. Niedrigere Werte führen meist zu weniger variierenden Antworten. Sie verhindern jedoch keine sachlichen Fehler. Vertiefung: Temperatur
Das Wissen: Informationen finden und nutzbar machen
Der angegebene zeitliche Stand des Trainingswissens. Er bedeutet nicht, dass das Modell alles davor weiss. Aktuellere Informationen können durch Dokumente oder Suchwerkzeuge hinzukommen.
Zahlenvektoren, die Eigenschaften und Bedeutungsähnlichkeiten von Inhalten abbilden. Sie helfen beispielsweise, passende Dokumente auch ohne identische Suchwörter zu finden.
Eine Datenbank, die solche Zahlenvektoren speichert und nach Ähnlichkeit durchsuchen kann. Inhaltliche Ähnlichkeit ist allerdings kein Beweis für Richtigkeit.
Das Aufteilen grosser Dokumente in kleinere, zusammenhängende Abschnitte. Dadurch lassen sich passende Stellen gezielt abrufen. Ungünstige Schnittstellen können eine Regel von ihrer Ausnahme trennen.
Das erneute Bewerten und Sortieren bereits gefundener Suchtreffer. Ein zusätzlicher Verarbeitungsschritt prüft, welche Ergebnisse zur konkreten Frage am besten passen. Vertiefung zu Dokumentaufbereitung und Suche
Ein Verfahren, bei dem ein System passende Informationen aus einer Wissensquelle abruft und dem Modell für die Antwort bereitstellt. Beispiel: relevante Abschnitte aus einem internen Handbuch. Ein Datei-Upload allein beschreibt noch kein vollständiges RAG-Verfahren. Vertiefung: RAG
Das Verankern einer Antwort in konkreten Quellen oder Daten. RAG ist eine Möglichkeit dafür. Auch eine quellenbasierte Antwort kann Fehler enthalten, etwa durch veraltete Quellen.
Ausgaben nach einem festgelegten Datenschema, beispielsweise mit Pflichtfeldern für Datum, Betrag und Währung. Das erleichtert die Weiterverarbeitung. Ein korrektes Format garantiert keine korrekten Inhalte. Vertiefung: Strukturierte Ausgaben
Die Handlungsmöglichkeiten: Werkzeuge, Agenten und ihr Gerüst
Eine definierte Schnittstelle, über die Programme miteinander kommunizieren. Darüber kann eine Anwendung ein KI-Modell ansprechen oder Daten aus einem anderen System abrufen.
Eine Integration, die eine KI-Anwendung mit einem anderen System verbindet, etwa einer Dokumentenablage oder einem CRM. Verfügbare Funktionen hängen von Integration und Berechtigungen ab.
Das Modell fordert ein Werkzeug an, beispielsweise eine Suche oder Berechnung. Die Anwendung führt den Aufruf aus und stellt das Ergebnis bereit.
Ein offener Standard, der KI-Anwendungen mit Datenquellen und Werkzeugen verbindet. Zugriffsrechte und Sicherheitsgrenzen bleiben bestehen. MCP umgeht keine Schutzmechanismen. Vertiefung: MCP
Ein festgelegter Arbeitsablauf, etwa «Dokument lesen → Angaben extrahieren → Entwurf erstellen → prüfen». Einzelne Schritte können durch KI unterstützt werden.
Ein KI-System, das innerhalb vorgegebener Grenzen mehrere Arbeitsschritte selbst steuert, Werkzeuge nutzt und sein Vorgehen anhand von Ergebnissen anpasst. Bei einem Agenten entscheidet das Modell stärker über den weiteren Ablauf als bei einem festgelegten Workflow. Vertiefung: Workflows und Agenten
Der Harness ist das Software-Gerüst rund um das Modell. Es stellt Kontext bereit, führt Werkzeugaufrufe aus und gibt Ergebnisse zurück. Dazu können Freigaben, Fehlerbehandlung und gespeicherte Arbeitsstände gehören. Seine Gestaltung heisst Harness Engineering. Vertiefung: Harness
Wiederverwendbare Pakete aus Anweisungen, Beispielen und gegebenenfalls Dateien oder Skripten. Ein Skill kann beschreiben, wie ein Angebot nach einer bestimmten Vorlage erstellt werden soll. Das Modell wird dabei nicht neu trainiert. Vertiefung: Agent Skills
Die Koordination von Modellen, Werkzeugen und Arbeitsschritten: Was passiert wann, welche Informationen werden weitergegeben und wie werden Fehler behandelt?
Ein System mit mehreren zusammenarbeitenden Agenten, etwa für Recherche, Entwurf und Prüfung. Sie können dasselbe Grundmodell verwenden. Mehr Agenten bedeuten zusätzlichen Abstimmungsaufwand und nicht automatisch bessere Ergebnisse. Vertiefung: Multi-Agent-Orchestrierung
Der Umfang, in dem ein Agent selbstständig handeln darf. Technische Fähigkeiten und erteilte Befugnisse sind unterschiedliche Dinge: Ein leistungsfähiger Agent kann bewusst auf wenige Aktionen beschränkt sein.
Die Qualität: Ergebnisse prüfen und Handlungen begrenzen
Eine falsche oder unbelegte Ausgabe, die plausibel wirkt. Beispiele sind erfundene Quellen, falsche Zahlen oder nicht existierende Funktionen. Sprachliche Sicherheit beweist keine sachliche Richtigkeit.
Systematische Verzerrungen in Daten, Modellen oder Ergebnissen. Dadurch können bestimmte Perspektiven überbetont oder Personengruppen unterschiedlich behandelt werden.
Ein Versuch, die KI durch eingeschleuste Anweisungen umzulenken, etwa in einer Webseite oder einem Dokument. Dabei kann zu analysierender Inhalt fälschlich als Arbeitsanweisung behandelt werden.
Schutz- und Prüfmechanismen, die unerwünschte Eingaben, Ausgaben oder Aktionen erkennen oder begrenzen sollen. Beispiele sind Datenprüfungen, Freigaben und Filter. Sie garantieren keine Fehlerfreiheit.
Berechtigungen bestimmen, welche Daten und Funktionen ein System nutzen darf. «Least Privilege» bedeutet, nur erforderliche Rechte zu vergeben. Eine Prompt-Anweisung ersetzt keine technische Zugriffskontrolle.
Eine abgeschirmte Ausführungsumgebung, die beispielsweise Datei- und Netzwerkzugriffe begrenzt. Wie wirksam diese Grenzen sind, hängt von der Umsetzung ab. Vertiefung zu Zugriffen und Schutzmechanismen
Ein Mensch ist gezielt in einen KI-gestützten Ablauf eingebunden, etwa zur fachlichen Prüfung oder Freigabe. Entscheidend ist, dass diese Kontrolle tatsächlich wirksam ist.
Systematische Prüfungen anhand definierter Aufgaben und Bewertungskriterien. Sie zeigen, wie zuverlässig ein KI-System für einen konkreten Einsatzzweck arbeitet. Eine gelungene Demo ersetzt sie nicht.
Ein definierter Satz von Testaufgaben zum Vergleichen von Systemen. Gute Ergebnisse zeigen Leistung auf diesen Aufgaben, garantieren aber keine gleich gute Leistung im eigenen Arbeitsalltag. Vertiefung: Evaluationen und Benchmarks
Das Nachvollziehen des beobachtbaren Ablaufs: Welche Werkzeuge wurden aufgerufen, welche Ergebnisse kamen zurück, wo entstanden Fehler oder Kosten? Die Protokolle zeigen nicht sämtliche internen Modellprozesse. Vertiefung: Agent Tracing
Ein gespeicherter Zwischenstand, der das Fortsetzen unterbrochener Aufgaben ermöglichen kann. Bereits ausgeführte externe Aktionen werden dadurch nicht automatisch rückgängig gemacht. Beim Training bezeichnet er einen gespeicherten Trainingsstand. Vertiefung: Workflow-Checkpoints
Die Technik: Wie Modelle lernen und arbeiten
Lernprozess, bei dem Modellparameter anhand von Daten und Lernzielen angepasst werden. Ein normales Gespräch verändert diese Parameter nicht unmittelbar.
Die grundlegende Trainingsphase, in der ein Modell allgemeine Muster lernt. Bei vielen Sprachmodellen gehört dazu, anhand eines Textkontexts den nächsten Token vorherzusagen.
Weitere Trainingsschritte nach dem Vortraining, um etwa Anweisungen besser zu befolgen oder bestimmte Fähigkeiten zu verbessern. Dazu können Fine-Tuning und bestärkendes Lernen gehören.
Das Weitertrainieren eines vorhandenen Modells mit ausgewählten Daten, etwa für bestimmte Aufgaben, Ausgabeformate oder einen Schreibstil. Es garantiert weder aktuelles Wissen noch fehlerfreie Antworten.
Beim bestärkenden Lernen wird ein Modell mithilfe von Bewertungssignalen trainiert. RLHF steht für «Reinforcement Learning from Human Feedback» und nutzt menschliches Feedback, häufig über ein daraus gelerntes Bewertungsmodell. Hohe Bewertungen garantieren keine sachliche Richtigkeit. Vertiefung: RLHF
Die Nutzung eines trainierten Modells, beispielsweise zum Erzeugen einer Antwort. Dabei werden seine gelernten Parameter normalerweise nicht verändert.
Die beim Training angepassten Zahlenwerte eines Modells. In ihnen sind gelernte Zusammenhänge verteilt repräsentiert. Die Parameterzahl allein sagt wenig über die Eignung für eine konkrete Aufgabe aus.
Ein Modell lernt aus Ausgaben oder anderen Signalen eines leistungsfähigen Lehrermodells. Häufig soll dadurch ein kleineres Modell Aufgaben mit weniger Ressourcen gut lösen. Vertiefung: Fine-Tuning und Destillation
Modellwerte werden mit geringerer Zahlenpräzision dargestellt. Das spart Speicher und kann die Ausführung beschleunigen. Mögliche Qualitätsverluste hängen vom Modell, Verfahren und Einsatzzweck ab.
Eine Architektur neuronaler Netze, deren Attention-Mechanismen Beziehungen zwischen Eingabebausteinen gewichten. Sie bildet die Grundlage vieler Sprachmodelle und wird auch für andere Datentypen verwendet. Vertiefung: Transformer
Ein generatives Modell, das lernt, schrittweise Rauschen zu entfernen und daraus beispielsweise Bilder zu erzeugen. Ein Diffusionsmodell kann dabei Transformer-Bausteine nutzen. Vertiefung: Diffusion
Eine Architektur, bei der pro Token ausgewählte Experten-Teilnetze aktiviert werden. Das spart Rechenarbeit. Diese Experten sind nicht automatisch Fachspezialisten für Themen wie Recht oder Marketing. Vertiefung: MoE
Die Bearbeitung von Aufgaben, die mehrere Schlussfolgerungen erfordern. Reasoning-Modelle sind dafür besonders trainiert und nutzen häufig zusätzliche Rechenschritte. Auch dabei können falsche Schlüsse entstehen.
Eine sprachlich formulierte Folge von Zwischenschritten zur Lösung einer Aufgabe. Sie kann Ergebnisse verbessern, ist aber nicht zwingend sichtbar oder eine getreue Erklärung der internen Verarbeitung. Vertiefung: Grenzen sichtbarer Begründungen
Ein Architekturansatz mit wiederholten internen Verarbeitungsschritten, ohne jeden Schritt als Text auszugeben. Das ist nicht einfach eine ausgeblendete Chain of Thought. Vertiefung: Recurrent Depth
Die Wartezeit bis zu einer Reaktion oder einem vollständigen Ergebnis. Zusätzliche Modellschritte und Werkzeugaufrufe können sie erhöhen. Ein schnell beginnender Text bedeutet nicht zwingend, dass die gesamte Aufgabe schnell erledigt ist.
Ein Modell läuft auf dem eigenen Gerät statt auf einem entfernten Server. Das kann Offline-Nutzung ermöglichen und Datenübertragungen reduzieren. Ob die gesamte Anwendung lokal bleibt, hängt auch von ihren Zusatzdiensten ab.
Open Weights bedeutet, dass Modellgewichte zugänglich sind; die Lizenz bestimmt die Nutzungsmöglichkeiten. Open Source AI umfasst nach der OSI-Definition zusätzlich Code, Informationen zu Trainingsdaten und weitreichende Nutzungs- und Änderungsrechte. Vertiefung: OSI-Definition
Die Forschung: Begriffe aus der Zukunftsdebatte
Die Vorstellung einer allgemeinen KI, die ein breites Spektrum geistiger Aufgaben auf menschlichem Niveau oder darüber bewältigen kann. Eine allgemein anerkannte Definition und ein einheitlicher Nachweis fehlen.
Ein Modell, das Zusammenhänge einer Umgebung abbildet und deren Entwicklung vorhersagen kann – beispielsweise, wie sich eine Handlung auf eine simulierte oder reale Umgebung auswirkt.
Gezielte Modellveränderungen, die das Ablehnungsverhalten abschwächen oder entfernen sollen. Sie machen ein Modell nicht automatisch kompetenter und entfernen nicht sämtliche Sicherheitsmechanismen einer Anwendung. Vertiefung: Ablehnungsverhalten
Ein Beispiel aus dem Arbeitsalltag: ein Angebot erstellen
Nehmen wir an, wir möchten einen Angebotsentwurf erstellen lassen. Der Prompt beschreibt den Auftrag. Ein Skill liefert Aufbau, Ton und Vorlage. Über einen Connector erhält die Anwendung Zugriff auf freigegebene Kundendaten. RAG kann passende Abschnitte aus Leistungsbeschreibungen bereitstellen.
Das Modell verarbeitet diese Informationen und erstellt den Entwurf. Der Harness organisiert Werkzeugaufrufe und den weiteren Ablauf. Berechtigungen begrenzen, auf welche Daten das System zugreifen und welche Aktionen es ausführen darf. Vor dem Versand prüft und genehmigt ein Mensch das Angebot.
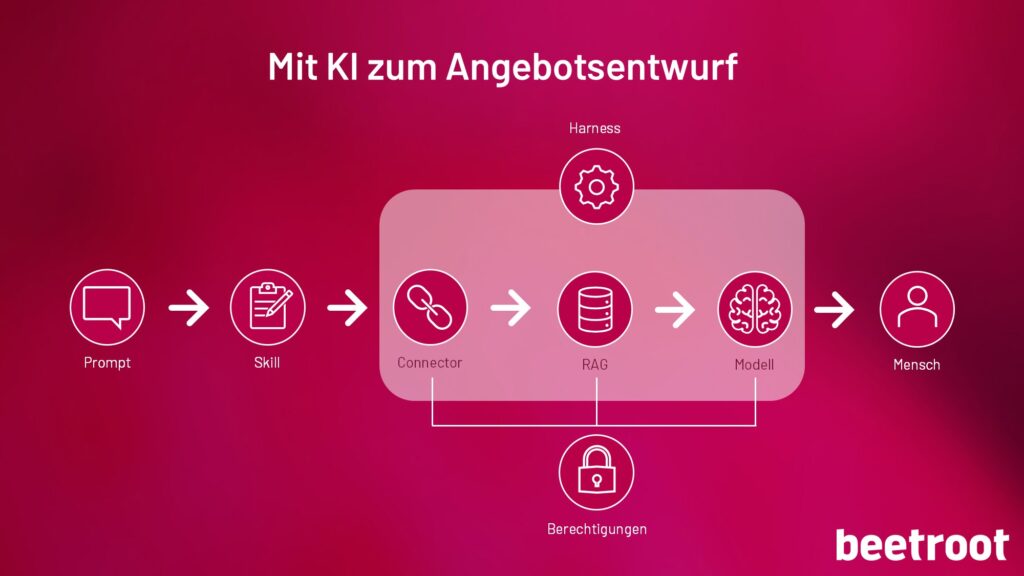
An diesem Beispiel wird deutlich, weshalb die Wahl des Modells nur ein Teil der Aufgabe ist. Ebenso entscheidend sind passende Informationen, geeignete Werkzeuge, klare Befugnisse und eine wirksame Qualitätsprüfung.
Man muss nicht alle Begriffe auswendig kennen. Für den nächsten KI-Anwendungsfall helfen bereits vier Fragen:
- Welche Aufgabe soll das System übernehmen?
- Welche Informationen braucht es dafür?
- Was darf es selbstständig tun?
- Woran erkennen wir ein gutes Ergebnis?
Diese Fragen schaffen eine Grundlage, um KI gezielt einzusetzen und ihren Nutzen im eigenen Arbeitsalltag zu beurteilen.